Segmenter de grandes images avec moins de ressources
Calcul exact hors-cœur et segmentation interactive incrémentale : deux apports d’une thèse CIFRE menée entre le LIGM et Thermo Fisher Scientific.
Français · Read in English
Les objets d’intérêt d’une image peuvent apparaître à plusieurs échelles : une cellule et ses organites, un animal et les parties de son corps. La segmentation consiste à délimiter ces régions. Un unique niveau de découpage ne suffit donc pas toujours à représenter les structures utiles à l’analyse.
Ma thèse CIFRE, Algorithmes scalables pour la segmentation hiérarchique d’images et de données, menée à ESIEE Paris, entre le LIGM et Thermo Fisher Scientific, cherche à rendre la segmentation hiérarchique utilisable sur de grandes images, malgré ses besoins en mémoire et en temps de calcul.
Une image, plusieurs échelles
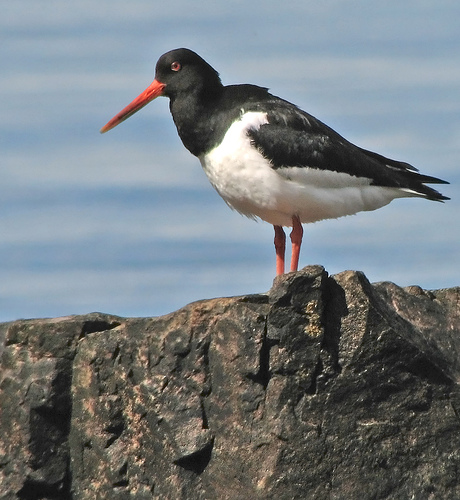
Une hiérarchie de segmentation rassemble plusieurs partitions de la même image, de la plus fine à la plus grossière. De petites régions se regroupent progressivement pour en former de plus grandes. Ces partitions sont imbriquées : deux régions de la hiérarchie sont disjointes, ou l’une est incluse dans l’autre.
On peut ainsi rechercher un oiseau entier à une échelle et son bec à une autre. La hiérarchie permet de choisir les régions au niveau de détail adapté à l’objet recherché, sans fixer une seule échelle pour toute l’analyse. La figure ci-dessous relie les partitions de l’image à leur représentation par un arbre.
Déplacez le curseur, puis cliquez dans l’image ou sur un nœud de la hiérarchie.
Chargement de la hiérarchie…
Construire et exploiter cette représentation a toutefois un coût : il faut stocker et manipuler les relations entre régions, en plus des pixels. Sur les volumes 3D de plusieurs milliards de voxels produits en microscopie électronique, la mémoire vive devient un obstacle. Lorsqu’un utilisateur affine une segmentation, c’est aussi le temps de réponse qui compte. Les deux volets de la thèse répondent à ces contraintes : calculer les hiérarchies avec moins de mémoire, puis accélérer les corrections interactives.
Premier volet : le calcul exact hors-cœur
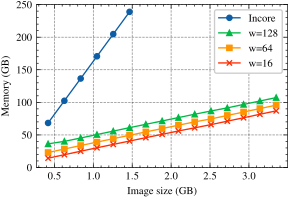
Une méthode en cœur conserve l’image et ses structures de calcul en mémoire vive. Ces structures peuvent être bien plus volumineuses que les pixels : une image de 3,35 Go peut nécessiter plusieurs centaines de gigaoctets pour construire sa hiérarchie. Le volume FIB-SEM étudié dans la thèse contient 2048 × 1536 × 1065 voxels, soit environ 3,35 milliards de voxels en 8 bits. L’algorithme classique en cœur ne pouvait pas traiter ce volume complet sur la station de 256 Go utilisée pour l’étude.
Le principe de l’algoritmique hors-cœur est de conserver les données sur disque et de ne charger en mémoire que les blocs nécessaires à l’étape courante afin de limiter l’usage de la mémoire vive.
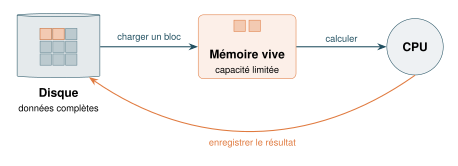
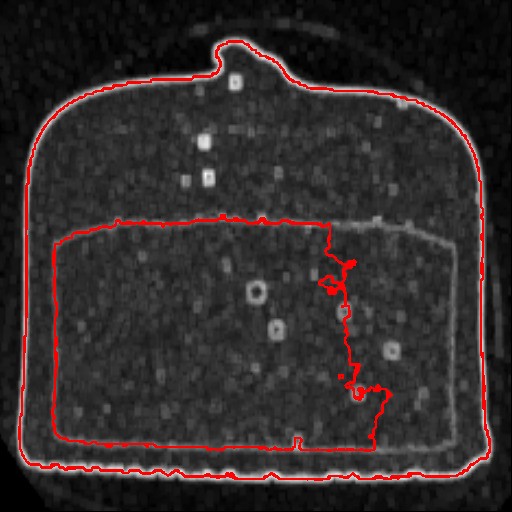
Le défi scientifique est de préserver les relations d’inclusion entre les régions, même lorsqu’une région couvre plusieurs blocs. Traiter chaque bloc indépendamment de manière naïve peut créer des frontières artificielles :
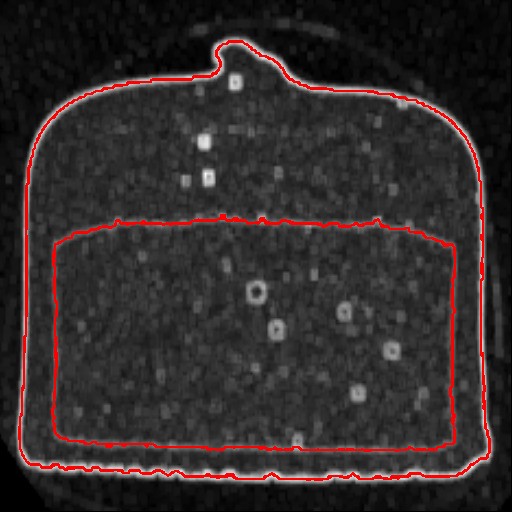
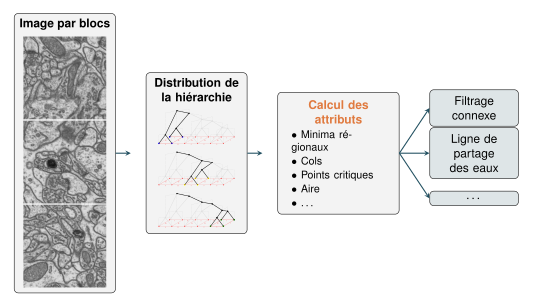
Notre cadre algébrique construit une distribution de la hiérarchie binaire de partitions : chaque bloc dispose d’un arbre local, cohérent avec la représentation globale. Trois opérations organisent le calcul : select extrait l’information utile, join combine les informations de blocs voisins et insert corrige et complète les hiérarchies locales.
La validité est établie mathématiquement : le calcul par blocs retrouve exactement la hiérarchie du calcul global. Nous proposons un schéma de calcul qui borne la taille des structures intermédiaires par rapport aux éléments voisins de la distribution.
Les fondements mathématiques
Le chapitre 4 et ses preuves en annexe comprennent 5 définitions et 9 résultats mathématiques : 3 propriétés, 5 lemmes et 1 corollaire. Ils formalisent les opérations, les relations entre représentations et les bornes sur les structures intermédiaires.
Pour une hiérarchie globale \(H\) et un bloc \(S_i\), l’élément recherché est
\[H_i = \operatorname{select}(S_i,H).\]L’objectif est de construire ces éléments sans devoir stocker préalablement toute la hiérarchie \(H\) en mémoire. L’exactitude concerne ce calcul ; la pertinence d’une segmentation pour une application reste une question distincte.
Ce cadre s’étend au calcul de caractéristiques régionales comme l’aire, le volume, la hauteur, les minima ainsi qu’à la segmentation par ligne de partage des eaux, notamment hiérarchique.
Quelle taille d’image peut-on traiter ?
La taille du fichier ne suffit pas à savoir si une image peut être traitée : il faut aussi tenir compte de la mémoire nécessaire à la hiérarchie et au calcul. En inversant les modèles issus des expériences, on obtient une taille maximale d’image estimée pour un budget mémoire donné.
Avec 32 Go pour le calcul, ces modèles donnent environ 196 Mo d’image en cœur, contre 10,7 Go avec une représentation hors-cœur optimisée, pour des images 8 bits non compressées. Le principe de cette représentation compacte est détaillé dans la section suivante.
Estimer la taille maximale d’image
Choisissez la mémoire disponible pour le calcul. Le tableau estime la taille maximale d’une image 8 bits non compressée selon les deux modèles.
| Méthode | Taille maximale estimée de l’image | Nombre de voxels en 8 bits |
|---|---|---|
| En cœur | ||
| Hors-cœur optimisé |
Estimations sans marge supplémentaire. La représentation optimisée et ses paramètres sont présentés dans la section suivante. Les résultats dépendent des données, du découpage et de l’implémentation ; ils ne constituent pas une capacité garantie.
Les calculs et leurs hypothèses
Pour une image de taille \(S\) et un pic mémoire \(M\), en Go, l’ajustement des six points de la figure 4.11(a) donne
\[M_{\mathrm{en\ cœur}}\approx162{,}94S+0{,}062.\]La configuration hors-cœur optimisée atteint un minimum proche de trois fois la taille de l’image. Pour un budget mémoire \(B\), les tailles maximales estimées sont donc
\[S_{\max,\mathrm{en\ cœur}}\approx\frac{B-0{,}062}{162{,}94}, \qquad S_{\max,\mathrm{hors\ cœur}}\approx\frac{B}{3}.\]Pour \(B=32\) Go, cela donne environ \(0{,}196\) Go en cœur et \(10{,}7\) Go hors-cœur.
Pour le volume complet de 3,35 Go, prolonger la tendance en cœur donne environ 550 Go, à comparer aux 10 Go mesurés pour la configuration optimisée : environ 98 % de réduction estimée. Cette comparaison entre les implémentations des chapitres 4 et 6 est distincte du gain mesuré de 84 % entre configurations hors-cœur, présenté plus loin.
L’ajustement a été reconstitué à partir des points de la figure, sans les journaux de mesure bruts. Le coefficient hors-cœur dépend du contenu de l’image, du découpage et des choix de représentation détaillés dans la section suivante. Il ne définit pas une limite universelle de la méthode. Les Go sont décimaux : pour une image 8 bits non compressée, 1 Go correspond à un milliard de voxels.
Des représentations plus compactes
Pour réduire davantage les ressources nécessaires, nous regroupons les pixels en superpixels, définis par des zones quasi-plates. Le paramètre \(\alpha\) règle la granularité de cette représentation.
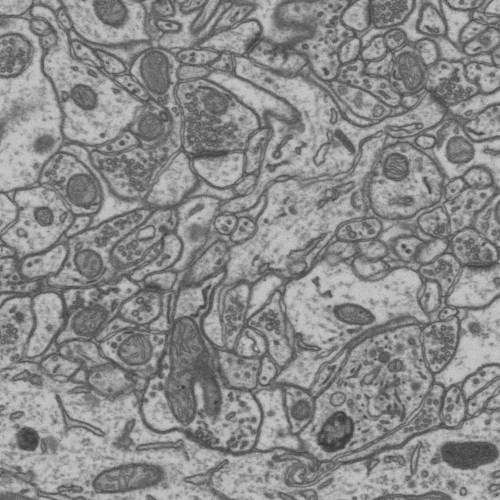
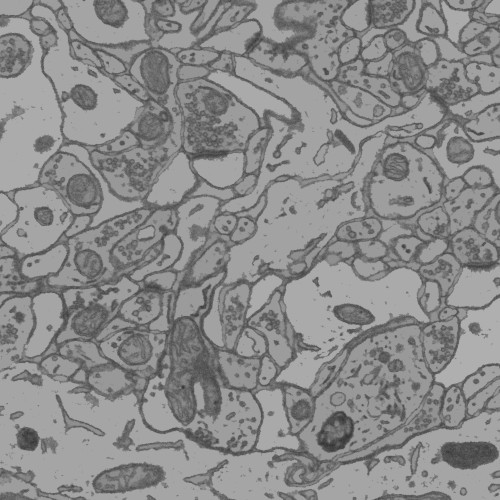
Pour la ligne de partage des eaux à partir de marqueurs, le calcul sur cette représentation conserve le résultat au niveau des pixels lorsque les marqueurs occupent des zones quasi-plates distinctes. Cette condition préserve l’information nécessaire pour les séparer.
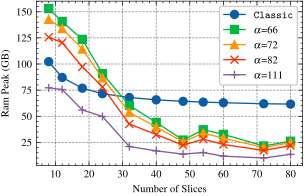
Les expériences de construction de la distribution, menées avec l’implémentation interne sur une station de 256 Go, donnent les résultats suivants :
| Ressource | Résultat pour α = 111 |
|---|---|
| Mémoire vive | Pic minimal réduit d’environ 84 % : environ 10 Go contre 62 Go. |
| Stockage temporaire | Environ 40 Go contre 299 Go, soit 87 % de réduction. |
| Temps de construction | Environ 40 min contre 100 min, soit 60 % de réduction. |
Les deux configurations sont hors-cœur : la comparaison porte sur le niveau pixel et le niveau superpixel, avec des stratégies de partitionnement différentes. Les 84 % comparent les minima obtenus en faisant varier le nombre de blocs ; le stockage et le temps sont comparés à 80 blocs.
Deuxième volet : accélérer la segmentation interactive
Le premier volet permet de traiter de grandes images malgré la mémoire limitée. Un autre obstacle apparaît pendant l’utilisation : attendre le résultat après chaque correction. Ce second volet exploite la hiérarchie pour accélérer la segmentation interactive par ligne de partage des eaux, lorsque l’image et les structures de calcul tiennent en mémoire.
En segmentation interactive, l’utilisateur désigne les objets d’intérêt et le fond à l’aide de marqueurs, observe le résultat, puis ajoute ou efface des marqueurs pour affiner les contours.
Cette démarche est incrémentale par nature : d’une étape à l’autre, l’image reste la même et les indications de l’utilisateur évoluent progressivement. Pourtant, les implémentations non incrémentales de la ligne de partage des eaux traitent chaque correction comme un nouveau problème : elles relancent le calcul de la segmentation sur toute l’image, même pour une modification locale. Ces recalculs successifs imposent une attente répétée à l’utilisateur.
Notre méthode incrémentale conserve l’état du calcul entre deux interactions. Elle réutilise les résultats précédents et actualise uniquement les régions affectées par l’ajout ou le retrait d’un marqueur. Le coût de la mise à jour est proportionnel au nombre de pixels concernés : une correction locale peut donc être prise en compte rapidement, ce qui facilite l’affinage progressif de la segmentation.
Une stratégie parallèle accélère les mises à jour importantes. Sur les cinq volumes 3D du benchmark, le temps moyen atteint 0,34 seconde par interaction, contre 9,26 secondes pour ITK, soit une accélération d’environ 27 fois, hors initialisation.
Un partenariat industriel et scientifique
La collaboration a permis de remplir conjointement les objectifs industriels et scientifiques. Les besoins opérationnels de Thermo Fisher Scientific ont nourri les questions de recherche ; le LIGM a apporté son expertise en morphologie mathématique et en algorithmique des graphes. Les solutions développées associent garanties mathématiques, performances mesurées et développement logiciel.
Les travaux ont donné lieu à deux articles de revue et trois publications en conférences internationales, tout en préparant leur transfert vers les outils de l’entreprise. Le démonstrateur Amira™ a notamment été présenté à VivaTech en 2025. Le code C++ de la segmentation interactive incrémentale accompagne la publication correspondante.
Les personnes ayant contribué aux travaux. Jean Cousty et Benjamin Perret, au LIGM/ESIEE Paris, et Harold Phelippeau, chez Thermo Fisher Scientific, ont assuré l’encadrement de la thèse. La segmentation interactive a été développée avec Quentin Lebon. Matheus Sano a également participé aux travaux dans le cadre de son stage. Je remercie aussi Nicolas Constanty, Franck Fauverte et Daniel Lichau pour leur contribution au démonstrateur Amira™.
Les suites envisagées
La poursuite des travaux vise à :
- réduire la duplication des régions en construisant les hiérarchies par plages d’échelles successives, pour faciliter le traitement à pleine résolution ;
- rapprocher le hors-cœur et la segmentation interactive incrémentale ;
- enrichir le calcul des caractéristiques géométriques des régions ;
- étudier les architectures parallèles, distribuées et GPU, ainsi que les complémentarités avec l’apprentissage profond.
Ces perspectives scientifiques accompagnent la consolidation du démonstrateur et l’évaluation de son intégration dans les logiciels Amira™/Avizo™, sur des données et des usages plus variés.